作者|郭海惟
邮箱|guohaiwei@pingwest.com
当许多台G1于舞台之上做出下腰动作, 在表演一种类似醉拳的姿态时, 你就会产生一种感觉, 仿佛宇树已然将表演这件事推进到极致的程度了。
着实难以想象, 处在羊年之际, 究竟还会存有何种事物, 能够比马年时那些更具震撼力地去叩击人心的表演。哪怕给出这样一种情形, 也就是安排机器人于舞台之上展现跳芭蕾的姿态, 且此姿态乃是一个相较后空翻具有无数倍难度的动作, 然则这就能给予普通民众胜过今日这般更为强劲的视觉上的极度震撼之感吗? 恐怕也难以轻易做出肯定的断言。
倘若讲当下具身存有一项“结构性”的矛盾, 大致便是“逐渐递增的姿态控制能力跟硬件水准”以及“落地场景不均衡、不全面”的发展相互间的矛盾。前头那个致使了民众对具身逐渐递增的期望, 然而后头这个却令民众心生困惑。
对于好些人来讲,机器人的“技能树”好似点错了, 它本应帮我们处理家务, 却反倒替我们进行诗词歌赋相关之事, 上演载歌载舞。
就在这般技能树错配的背后, 实际上是存在着第二个“结构性”的矛盾, 具体来讲就是, 那展现为“日益增长的 AI 智能诉求”这一现状, 和“智能泛化能力表现不具备平衡性、呈现不充分状态”的发展态势之间出现的矛盾。前者从而致使在行业范畴内所有从事相关职业的人员, 都对 AGI 的未来满怀充满光明的信心, 然而后者却使得这些从业者体会到现金流方面处于贫穷的状况。
而所谓一切场景与智能的问题,其实本质都是数据与智能的关系。
在具身领域尤其如此。
而具身的数据问题又可以分成两种:
一方面存在数据规模将会致使智能难以实现scaling的情况, 另一方面是处于现有智能的状况下, 有着样本的学习以及泛化能力的情形。
曾有多位具身行业资深人士, 向硅星人表达看法, 称具身数据问题具备 “可解” 的特性, 然而其解决方案本质上大概率会呈现 “线性” 特征, 也就是会随着投入的增多, 获取较多的加速效果, 不过出现 “指数型” 爆炸的倾向较低。
深入探究其缘由, 倘若旨在透过仿真数据达成高度的通用泛化, 制作超高质量仿真数据背后所存之难度, 可能反倒比具身大脑泛化的难度更高, 存有类似“鸡生蛋、蛋生鸡”这般悖论的意味。至于互联网数据, 理论层面可行, 然而精准度不足, 恰似“画马难画骨”一般, 其对齐难度颇大, 有句号。
目前行业里普遍构想的一个技术循环是:
数据被采集, 之后数据对模型进行训练, 进而模型进入一种场景, 在该场景中会生成数据, 这些新的数据会变得更好, 基于更好的数据会有更强的模型出现, 更强的模型又会产生基于更多场景的数据。
如此这般慢慢来能将数据转动起来, 待数据增多了, 具身便可踏入GPT时刻, 虽说实际进程或许会颇为迟缓嘿。然而即便这样, 好多模型依旧会在第三步卡死, 致使数据飞轮长久没法转动起来。致使一些实际的技术循环实则是:
先开始数据采集, 接着进行数据训练模型, 然而泛化能力却在sim to real这里遭遇困境, 出现发展停滞的状况, 最后只能等待有数目更多的数据。
但在最近两个月期间, 逐渐连续地有更多团队投身加入到少样本乃至零样本的泛化能力的路线探寻求索上来, 借由不一样的路径去处理解决智能突破以及泛化能力的问题, 可与具身的马年学术春晚相媲美相当:
χ0是香港科技大学团队在2月10日正式发布的技术成果。
之前, 这个团队, 于12月期间, 曾以χ0开展了为时24小时的“家务播映活动”, 核心操作大多聚焦于抓取衣物, 随即进行折叠处理, 之后予以悬挂展示, 充分彰显出极为强劲的柔性物体处置水准。
依照往后发布的技术报告所呈现的情况来看, χ0能够于罕见的少量样本(20小时人类视频)、较低的算力(8张A100)这样的情形下, 展现出优良的泛化自身能力。并且依据他们自身给出的说法来讲, 相较于π0.5 , χ0获得成功的概率能够有高达250%的提升幅度。
就像这般, 如同这篇论文的题目标明的那样, “凭借化解分布不一致性, 达成资源受限状况下的鲁棒操控”。
呈现柔性物体能力的是χ0, 然而其旨在解决的实则是模型学习的鲁棒性这般难题。它的解决办法, 实际上是要解决不同模块里的数据, 分布对齐这一问题。
比如说, 以往训练生成的模型内部参数分布, 跟环境反馈给出的分布并不相同, 这就致使智能的鲁棒性受到损害。而他们期望在各个环节当中寻找到这些分布差异, 接着将其对齐——他们最终选定从训练分布(Ptrain)、模型分布(Qmodel)以及部署分布(Ptest)这三个角度着手, 进而使得流程的各个不同阶段都能够达成高效对齐。
1月30日, 蚂蚁灵波官宣了技术成果LingBot-VA, 官方把它称作具身世界模型, 它首创了自回归视频 - 动作世界建模框架, 还是第一个把世界模型用于直接控制真机操作下出现的研究成果。
在此之前, 蚂蚁灵波曾发布LingBot-World开源视频生成世界模型, 达成了将近10分钟的无损稳定的生成效果。
与χ0一样,LingBot-VA展现了更好的鲁棒性:
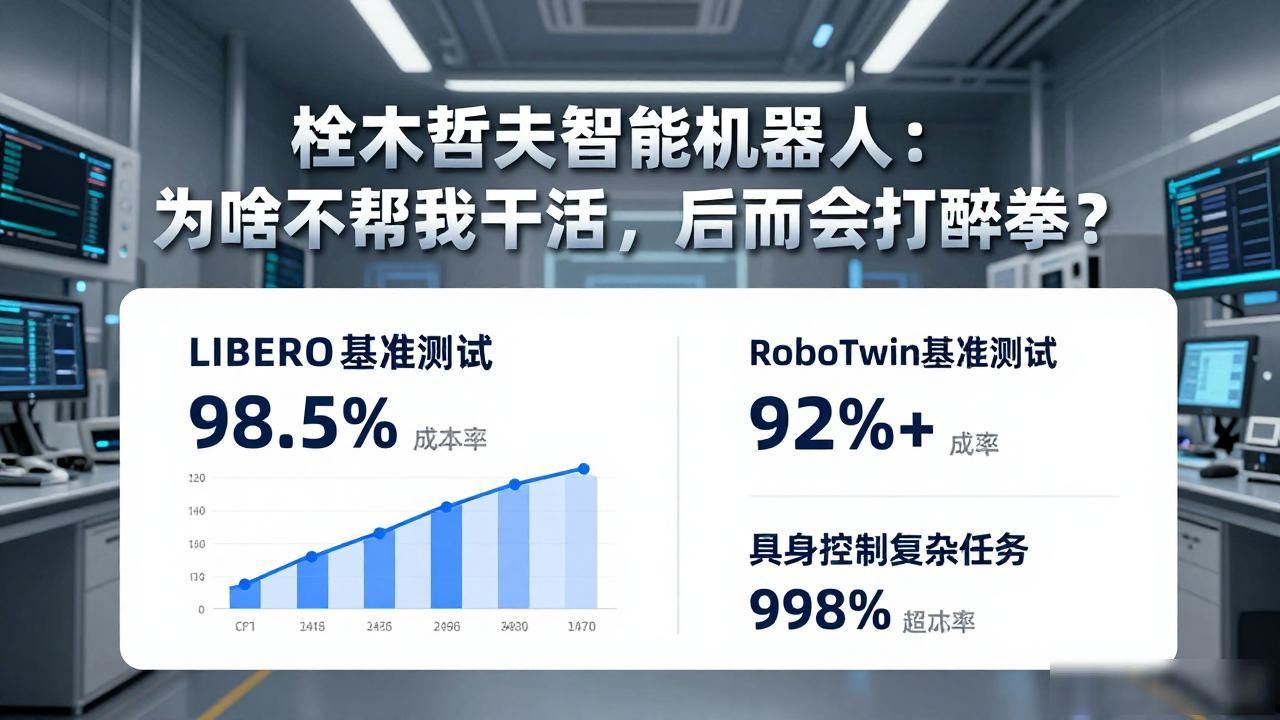
在LIBERO这一主流基准测试里, 以98.5%的成功率大幅领先π0.5等现有模型, 于RoboTwin这一主流基准测试中, 又以92% +的成功率大幅领先π0.5等现有模型, 针对具身控制中常见的“长时漂移”难题, 其复杂任务成功率超过98%。
同时也能实现较少样本下的泛化能力:
一个场景仅需 30~50 条演示数据即可完成适配。
和χ0不一样的是, LingBot-VA团队从头就挑了一个在语义方面具有较高稳健性的自回归世界模型策略。他们的逻辑类似在模型里安了一个预测未来的脑子。实质是拿一段视频去预测下一段视频的情形。一旦模型清楚下一段视频流中的状况 , 就能够反推并解码成具体的实施行动。
如此一来, 鉴于视频跟动作之间存在清晰明确的时间关联, 还存有明晰的逻辑关联, 于是自然而然就形成了在极为明确的物理现实世界当中的因果关系。因而这个技术成果被赋予了这样的命名: “面向机器人控制的因果世界建模”。
这套方案避开了VLA时常出现的表征纠缠类问题, 把动作, 涉及视频预测的情况, 还有场景执行的情状, 直接造就了彼此相互映射的关系。并且在视频生成模型的范畴里, 天然地会拥有一定的世界模型知识, 所以收获了更好的执行成效。
https://github.com/Robbyant/lingbot-va/blob/main/LingBot_VA_paper.pdf
是英伟达团队, 在2月份发布的技术论文, 名为DreamZero, 其定位为世界动作模型, 也就是WAM。
DreamZero比LingBot-VA晚发布了十天左右, 不过两者在思路上同为世界模型落地真机的路线, 所以在一些技术思路上也比较相似。并且Lingbo-VAt是搭配LingBot-World一起发布的。另外, 与DreamZero同期发布的还有DreamDojo的通用机器人世界模型。
这两个团队, 在技术审美方面, 是相似的, 在产品发布的逻辑节奏上, 也是相似的, 可以说是, 目前在世界模型的探索进程当中, 于东半球的团队扮演着先行者角色, 于西半球的团队同样扮演着先行者角色, 并且, 还在相当程度上, 确认了这样一条, 技术路线的可行性。
他们全都着重突出世界模型于运动控制里面所拥有的作用, 着重突出依靠世界模型去预测而非只是一味简单地堆放数据的关键性, 以及享受到世界模型带来益处相应的技术路线, DreamZero也展现出了还不错的泛化性。
官方宣称, 就是那种DreamZero能够达成0样本泛化, 哪怕是在一些模型压根儿都没遭遇到过的场景里头, 它也照样能行。并且, 为了突出强调这个要点, 他们以至于把专门的技术报告直接命名成, “世界动作模型是0样本泛化的策略”(请注意, 英文是World Action Models are Zero-shot Policies这儿的具体表述), 就是这么个情况。
最大的核心差异之处在于, LingBot运用了以自回归当作主干部分的一种策略, 然而DreamZero选用的却是将扩散模型直线当作主干进行构建的策略。而且, 当作为它们自身所属模型面向将来具备的一项基础设施来看的时候, 里面DreamDojo当中最主要的核心是处于闭源的情形之下, 反倒LingBot-World这个设施展现出从外到里全然是开源的状态。
https://dreamzero0.github.io/
押注“非线性”增长的物理世界
过去的具身技术路线正在受到越来越多的挑战。
一方面, 就像本文开头所讲的那样, LLM成功的那种路径依赖, 致使具身产业长久以来患上了数据饥渴症。然而, 数据规模在短时间之内很难实现爆发式增长, 这便造成具身的智能缺少像LLM那样指数级增长的办法。
另一方面, 实际上以VLA为代表的技术路线, 其自身也正面临着更多质疑;越来越多的人开始质疑, VLA能不能很好地完成动作操控? 有没有能力更好地进行泛化, 进而突破Sim to real gap的魔咒?
然而针对于这种困局, 不一样的人想到的解决办法不一, 并且在短期内很难达成一致的意见。
χ0 这类研究, 更像是借助持续升级以往架构能力, 进而在原本的路线上解决难题;然而 LingBot - VA 这一产品, 还有 DreamZero 这样的, 是在探寻一种具有革命性的范式革新。
今时这步入行业内部逐渐明晰的一种共识为: 若具身大脑之能力要挣脱数据贫血以及泛化瓶颈这般境况产生的限制, 进而去重现大语言模型那令人瞩目的成就, 那么就必定得有一些全新的技术革新。或者, 我们在数据这个层面做到大幅突破;再不然, 就是在架构方面谋求与众不同的路径。
转而像VA这样的工作明显地属于后者, 还有DreamZero这样的工作亦明显是后者, 而它们能够让我们获取到的启事是:
若是需在具身复刻大语言模型的规模定律奇迹, 那它不一定是经平移规模定律的法子达成的, 或许是凭借一个更为优秀的架构来获取原本在大语言模型里已然有的知识能力。
蚂蚁灵波首席科学家沈宇军在接受采访时表示:
LingBot-VA的思考, 跟LingBot-World的思考, 实际上是“一套技术体系的不同侧重”, 二者会耦合得极为深, 底层的数据引擎是高度共通的, 其代码框架也是高度共通的, 并且优化方法同样高度共通。
所以, 沈宇军的想法或许是, 要避开具身的scaling限制, 再度去考量并依赖新的大模型能力, 构建新的具身底层的智能基础设施。
以这个角度来讲, 蚂蚁灵波以及英伟达堪称具身世界模型里“拓荒者”的角色 , 在未来并不排除会出现更多类似英伟达和蚂蚁这般的超级玩家加入其中。然而伴随着中美在 AI 进展生态存在差异 , 未来英伟达会逐步构建起自身的生态 , 与此同时蚂蚁灵波会积极地引领全球的开源世界模型态。
但他们的目标都是一致的:
肉体呈现并非一定得循规蹈矩, 存在规则地进行, 物理人工智能同样值得一回呈现出爆发式增长态势的尝试。